
Matematika di Balik Mega Device Policy: Mengoptimasi Akurasi dan Efisiensi AI
Pada pembahasan sebelumnya, kita telah melihat bagaimana kaum Connectionist meniru cara kerja sel saraf otak manusia untuk membangun jaringan saraf tiruan. Kini, mari kita bawa konsep tersebut ke dalam situasi nyata di lingkungan sekolah: bayangkan sebuah sistem perlindungan digital bernama Mega Device Policy.
Sistem kecerdasan buatan (Artificial Intelligence) ini bertugas menjaga perangkat belajar siswa dengan cara menebak secara otomatis apakah sebuah situs web yang dibuka perlu di-lockdown (diblokir karena berbahaya atau mengganggu fokus belajar) atau aman untuk diakses. Namun, ada satu tantangan besar di lapangan: setiap hari, terdapat 150.000 halaman web yang dibuka oleh para siswa. Jika sistem harus menganalisis ratusan ribu halaman tersebut secara terus-menerus, penggunaan sumber daya komputasi (resource seperti memori dan prosesor) akan melonjak drastis dan membuat perangkat menjadi lambat.
Bagaimana cara melatih Mega Device Policy agar tebakannya mendekati kebenaran, sekaligus tetap hemat sumber daya? Jawabannya terletak pada optimasi menggunakan persamaan matematika.
1. Merumuskan Tebakan Lockdown: Persamaan Dasar Neuron
Ketika seorang siswa mengeklik sebuah tautan, sistem Mega Device Policy langsung membedah karakteristik halaman web tersebut menjadi angka-angka (disebut variabel masukan atau x), seperti kata kunci pada alamat situs, judul halaman, hingga jenis skrip di dalamnya.
Setiap karakteristik x dikalikan dengan tingkat kepentingannya yang disebut bobot w, lalu ditambahkan dengan nilai dasar bias b. Proses penilaian awal ini dituliskan dalam persamaan linear:
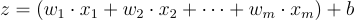
Karena keputusan kebijakan perangkat hanya memiliki dua pilihan tegas—yaitu aman (0) atau lockdown (1): nilai z tersebut kemudian dimasukkan ke dalam fungsi penyaring khusus bernama Sigmoid ( bentuknya kaya huruf z itu) untuk mengubahnya menjadi angka peluang (y topi, ada topinya) di antara 0 hingga 1:
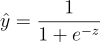
Jika hasil tebakan y topi mendekati 1(misalnya 0,92), sistem akan segera melakukan lockdown pada halaman tersebut. Sebaliknya, jika y topi mendekati 0 (misalnya 0,08), halaman dibiarkan terbuka.
2. Mengukur Jarak dari Kebenaran (Loss Function)
Pada tahap awal, bobot w masih berisi angka acak. Akibatnya, Mega Device Policy bisa melakukan dua jenis kesalahan fatal: meloloskan situs berbahaya yang seharusnya di-lockdown (y = 1, tetapi ditebak y topi = 0,1), atau justru memblokir situs materi pelajaran yang aman (y = 0, tetapi ditebak y topi = 0,9) seperti wayground haha.
Untuk mengukur seberapa jauh tebakan sistem (y topi melenceng dari kebenaran sesungguhnya y, digunakan rumus Loss Function (Fungsi Kerugian):
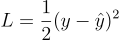
Selisih antara kebenaran dan tebakan dikuadratkan agar nilai kesalahan selalu positif dan memberikan "hukuman" yang jauh lebih besar jika sistem melakukan kesalahan yang fatal. Tujuan utama melatih sistem ini adalah menekan nilai kesalahan L hingga mendekati 0.
3. Tantangan 150.000 Halaman dan Solusi Mini-Batch Gradient Descent
Untuk memperbaiki bobot w agar kesalahannya berkurang, sistem menggunakan konsep kalkulus turunan (derivative) yang disebut Gradient Descent. Bayangkan nilai kesalahan L sebagai sebuah lembah, dan sistem harus melangkah turun mencari titik paling dasar menggunakan rumus pembaruan bobot:
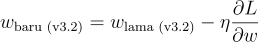
Simbol yang paling ujung menunjukkan arah kemiringan kesalahan, sedangkan (eta) kaya bentuk n adalah Learning Rate yang mengatur seberapa lebar langkah perbaikan sistem agar tidak kebablasan melompati titik kebenaran.
Di sinilah masalah penggunaan resource muncul. Jika sistem menggunakan cara konvensional (Batch Gradient Descent), ia harus menghitung rata-rata kesalahan dari seluruh 150.000 halaman sekaligus sebelum melakukan satu kali perbaikan bobot:
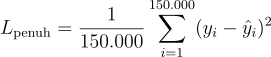
Menahan 150.000 data halaman di dalam memori secara bersamaan setiap hari akan menguras kapasitas server dan memperlambat jaringan sekolah. Untuk mengatasinya, matematika menawarkan metode Mini-Batch Gradient Descent. Alih-alih memproses 150.000 halaman sekaligus, data dipecah menjadi kelompok-kelompok kecil (batch), misalnya berisi B = 100 halaman per langkah:
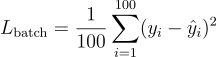
Dengan rumus mini-batch ini, sistem hanya membutuhkan memori yang sangat kecil untuk menghitung 100 halaman pada satu waktu, namun dapat memperbarui bobot w berkali-kali dalam sehari dengan jauh lebih cepat dan ringan.
4. Melacak Akar Kesalahan (Backpropagation dan Aturan Rantai)
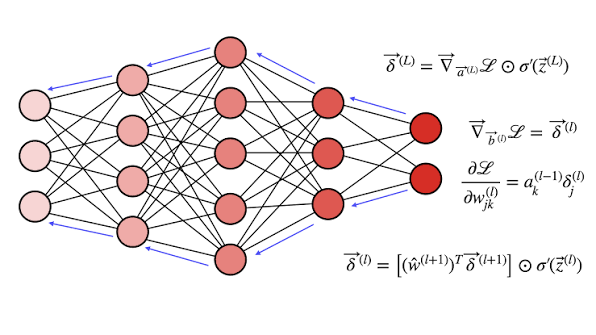
Misalkan seorang siswa membuka artikel biologi tentang "virus", lalu Mega Device Policy keliru melakukan lockdown. Untuk melacak karakteristik mana yang memicu kesalahan tersebut di dalam jaringan saraf tiruan yang berlapis-lapis, digunakanlah Aturan Rantai (Chain Rule) dalam algoritma Backpropagation:
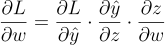
Persamaan rantai ini menelusuri kesalahan dari belakang ke depan. Sistem akan menyadari bahwa bobot w untuk kata "virus" terlalu sensitif sehingga perlu diturunkan, sementara bobot untuk kata pendukung seperti "sel" atau "pelajaran" perlu dinaikkan agar di masa depan artikel edukasi tidak ikut terblokir.
5. Memangkas Beban Komputasi dengan Regularisasi
Selain memecah jumlah halaman, tingginya penggunaan resource pada 150.000 halaman per hari juga disebabkan oleh terlalu banyaknya detail halaman web yang diperiksa. Padahal, tidak semua elemen situs web relevan untuk menentukan lockdown (misalnya warna latar belakang situs atau jenis huruf).
Agar sistem tidak membuang energi menghitung hal-hal yang tidak penting, ditambahkanlah rem matematis bernama Regularisasi L1 ke dalam fungsi kesalahan:
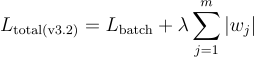
Suku tambahan bertindak seperti pengawas anggaran yang ketat. Nilai (lambda) akan menekan bobot w dari fitur-fitur halaman web yang tidak berguna hingga menyentuh angka 0. Dalam matematika, angka apa pun yang dikalikan dengan 0 akan menghasilkan 0 (0 . xj = 0). Artinya, sistem secara otomatis berhenti memeriksa fitur-fitur yang tidak penting tersebut, sehingga beban pemrosesan untuk 150.000 halaman setiap harinya menjadi jauh lebih ringan dan efisien.
Penerapan matematika pada Mega Device Policy membuktikan bahwa melatih kecerdasan buatan bukan hanya soal mengejar akurasi kebenaran semata, tetapi juga soal mengelola efisiensi sumber daya. Melalui fungsi peluang untuk menebak, metode mini-batch untuk meringankan beban memori dari 150.000 halaman harian, aturan rantai untuk mengoreksi kesalahan, serta regularisasi untuk memangkas perhitungan yang sia-sia, sebuah sistem dapat bekerja secara cerdas sekaligus hemat energi.
Seri Artikel
- Bagian Utama: Asal-Usul Aliran Connectionist
- Episode 2: Matematika di Balik Mega Device Policy: Mengoptimasi Akurasi dan Efisiensi AI